MirrorNet: High-fidelity and Scalable Network Emulation for Software-defined WAN¶
TL; DR
腾讯把自家多平面 SD-WAN(TWAN)做成一个"孪生"模拟环境。它复制生产 TE 控制器,用厂商路由器 VM 镜像加载生产配置,再用"快照 + 事件"回放把拓扑、隧道、流量矩阵和故障事件按依赖顺序注入进去,从而在秒级粒度上重建任意历史时刻的网络状态。
这个环境既能用于事后排障(backward),也能用于变更前验证(forward)。
1. 背景:TWAN 与 TE 控制环¶
TWAN 的结构:连接数百个 DC 站点。物理拓扑被切成多个并行的平面(plane),跨 DC 流量通过流级 ECMP 分到各平面。每个平面有独立的软件集中控制器,每台路由器上运行 agent。
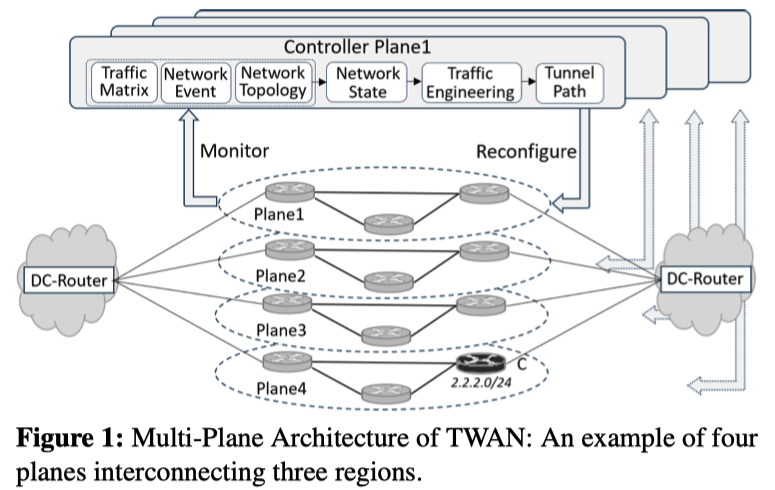
TE 控制环(每 5 分钟或按需触发):
- 轮询 agent,得到拓扑(有向图)和流量矩阵(来自字节计数器)。
- 运行 TE 算法,为每个站点对分配多条路径。
- 与现有路径做 diff,通过隧道(IP 封装)重配路由器。
2. 动机:四个生产案例¶
| 案例 | 现象 | 暴露的问题 |
|---|---|---|
| ① 无法追溯的故障 | AB 链路从 1000G 降到 500G,TE 判定"备用路径带宽不足",持续丢包 100 Gbps。事后在 MirrorNet 中复现才定位到 TE 算法 bug:背包问题的一维数组优化写错,导致数值覆盖 | 缺乏运行时日志,也无法复现当时的故障和流量条件 |
| ② 参数调优慢 | O(10) 个 TE 参数(最大链路利用率、负载不均阈值等)。阈值太低会导致频繁重调度,每次约 100 ms 丢包 | 在生产上迭代试参要花数月,且有风险 |
| ③ 单平面金丝雀测试不可靠 | 逐节点撤路由来隔离平面,前三个平面都正常,plane4 丢包 0.2%。原因是节点 C 配置 bug,没走 MPLS-TE 而是走 BGP | 各平面的流量差异可达数十倍(大象流只落在一个平面),配置也会漂移 |
| ④ 容量评估不准 | 2200G 的捆绑链路高峰期掉到 400G,丢包 3%,持续 1.5 小时 | 现有工具(如 RSS)没有集成真实 TE 算法和配置 |
现有工具的不足:
- CrystalNet:面向 DC,只用静态快照,无流量。
- Crescent:面向 WAN 故障场景,不考虑 TE 和流量需求。
- Batfish、Minesweeper、Hoyan 等验证工具:验证不了软件 bug 和厂商实现差异。
- 以上工具都只掌握部分生产信息。
三个需求:秒级高保真、可扩展(数千节点和链路)、资源高效(支持按需拉起)。
3. 系统架构¶
组成:
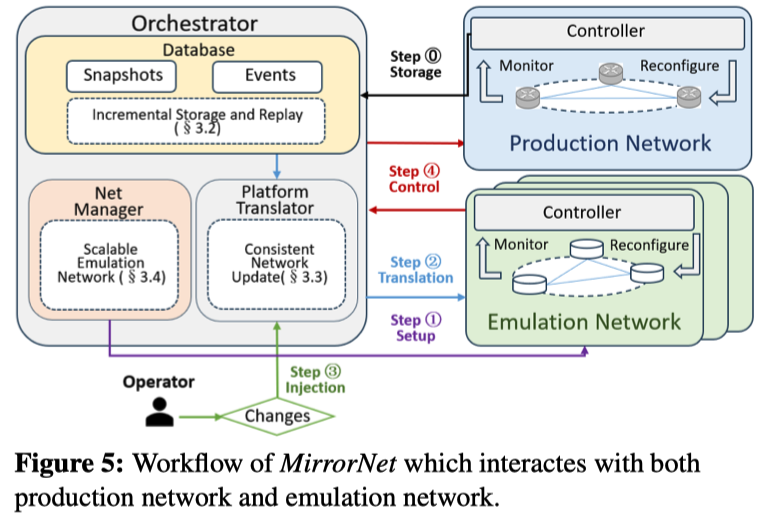
- Orchestrator:
- 包括数据库(快照 + 事件)、Net Manager(管理模拟网络生命周期)、Platform Translator(负责对齐生产与模拟网络)。
- 若干 Emulation Network:
- 每个相当于生产网络的一个平面,包含从生产复制的 TE 控制器,以及运行厂商路由器镜像的 VM(加载生产配置)。
工作流程:
- Step 0:持续采集快照、事件和流量矩阵,存入数据库
- Step 1:按任务部署一个或多个模拟网络
- Step 2:Translator 对齐状态
- Step 3:运维人员用与生产相同的接口施加变更
- Step 4:验证通过后应用到生产
4. 三项关键技术¶
4.1 增量存储与回放(§3.2)¶
数据量问题:单个平面每秒约 16 MB,每天约 1300 GB,每月约 40 TB
观察:拓扑数据在时间上高度冗余(Table 1)
| 数据 | 占比 | 变化频率 |
|---|---|---|
| 节点 | <0.1% | 约每年一次 |
| 链路属性 | 2.3% | 平均每条链路每天约 3 次 |
| 隧道 | 97.7% | 平均每条隧道每天约 1 次 |
因此只存变化量即可:链路约为全量的 3/86400 ≈ 0.003%,隧道约为 0.001%
做法:
- 周期快照(生产中为每小时一次)加事件日志(每月约 10 MB)。
- 重建时加载最近的前序快照,按时间戳串行应用事件。不能并发应用,否则 A-D-C 与 A-E-C 两次改路的顺序会错乱。
- 兜底机制:有些事件会因 bug 或拥塞而漏记。系统定期把快照存入缓存,与重建结果比对。一致则丢弃;不一致则把该快照落库,作为新的参考点。
4.2 一致性更新(§3.3)¶
核心观点:保真的关键在于数据注入顺序,而不是排队时延这类不会触发 TE 的因素。
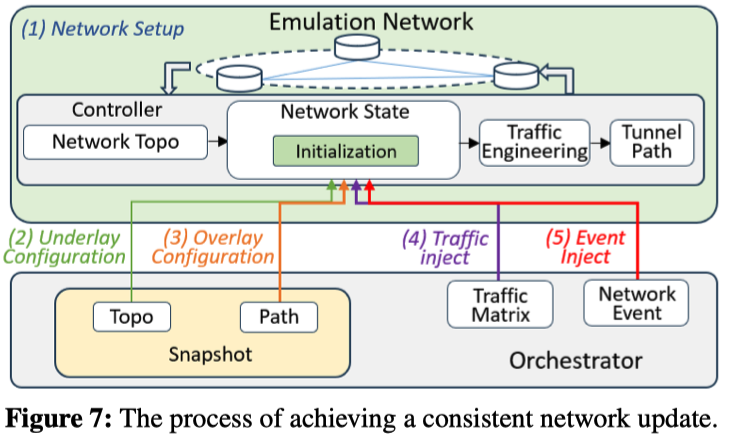
依赖树(Fig. 8):拓扑 → 节点/链路配置(underlay)→ 隧道路径(overlay)→ 流量注入(分钟级、隧道粒度)→ 事件注入。不同任务选用不同的子序列:
- 检查连通性:步骤 1、2、3、5。
- 评估高峰流量对调度的影响:步骤 1–4。
隧道映射(最棘手的是第 3 步):
- 问题:同一源宿之间有多条隧道,如果随意对应,流量会被分配到错误的模拟隧道上。
- 做法:按 ⟨源, 宿, 链路路径, 服务等级(gold/silver/bronze)⟩ 匹配并排序,建立生产隧道与模拟隧道的一对一映射。
4.3 可扩展的模拟网络(§3.4)¶
选型:
- 选择 VM 而非容器,因为要运行厂商的 Cisco/Juniper 镜像,且需要更好的隔离。
- 底层基于 GNS3 扩展。
被放弃的方案:
- OpenStack:为端主机设计,路由器这种多端口设备要创建大量虚拟端口,速度慢。
- 原生 GNS3:创建时间随规模近似二次增长,Kdl 拓扑约需 1 小时。
快速部署:原生 GNS3 是阻塞式的(创建→启动→注册→写工程文件,逐个进行)。MirrorNet 做了三点改动:
- 用线程池异步创建节点和链路。
- 创建与启动解耦,所有节点同时启动。
- 工程文件只在最后写一次。
并发模拟 + 流量共享:
- 串行测 64 个故障场景需要 21 小时,所以要多个模拟平面并行。
- 但每个平面的设备名、链路名都不同,映射无法直接复用。
- 解决办法是 Traffic Translator(Algorithm 1):全局只存一份流量数据,按各平面的隧道映射分别翻译。
实现:
- 约 1 万行 Python/Go 代码。
- 模拟网络运行在多台 96 核、512 GB 内存的服务器上,每台约承载 20 台设备,使用多主机 GNS3。
- Orchestrator 部署在一台 2 核 4 GB 的云 VM 上。
- 用 GoCron 调度任务,分按需和周期两类;数据存在 Kafka 中,按 topic 和时间戳读取。