Act Before It's Too Late: Power-Efficient LLM Inference on Mobile Device
针对移动端大语言模型(LLM)推理的高能效系统 TurboInfer
(1) Motivation & Insights
-
移动端 LLM 面临的严峻能耗瓶颈
- 随着量化、剪枝等技术的发展,LLM 逐渐向端侧(On-device)部署以保护隐私和降低延迟
- 但 LLM 自回归推理属于高负载任务,会造成手机电池迅速耗尽及剧烈发热
- 实测显示,在手机上运行 Gemma2-2B 等模型,功耗是日常常用应用(如社交、音乐、短视频、购物软件)的 3.11 至 6.15 倍,可使设备待机时间从 15 小时锐减至 2.5 小时左右
-
核心发现: MobileDevice-specific GPU Stalls
- 尽管 LLM 计算量大,但在移动 SoC 架构下,GPU 存在大量不可避免的空转/停顿(Stalls)
- Host 驱动的执行管线(Host-controlled pipeline):
- 移动端 CPU 作为主控,GPU 仅作为被调度的计算加速单元模型被拆分为数百上千个计算算子/Kernel
- 每个 Kernel 启动都需要 CPU 准备元数据、设置张量指针、提交命令,带来不可忽视的调度开销
- 统一共享内存架构(Shared DRAM Architecture):
- 与服务器端拥有高带宽独立显存(HBM)不同,移动端 CPU、GPU 共享同一片 DRAM,必须激烈竞争内存带宽
- 在自回归生成中,频繁的权重读取、KV Cache 更新及采样带来极大的内存争用与 I/O 开销
- Host 驱动的执行管线(Host-controlled pipeline):
- 量化结果:
- 在单 Token 生成周期内,GPU 等待张量准备的空转延迟可占据端到端推理延迟的 74% 以上
- 在 Token 间的解码间隔中,低端处理器上的停顿甚至高达总时间的 91.71%,且绝大多数算子处于 Memory-Bound 状态
- 尽管 LLM 计算量大,但在移动 SoC 架构下,GPU 存在大量不可避免的空转/停顿(Stalls)
-
现有调频机制(DVFS)为何失效?
- 默认系统 DVFS 滞后:
- Android 系统的默认调频器基于较粗粒度(通常为 1 秒)的 GPU 利用率指标
- 然而,毫秒级的频繁短暂停顿在 1 秒窗口内被平均掉了,导致系统误以为 GPU 始终满负荷运行,全程维持高频(甚至推理结束后 0.3~0.8 秒仍维持高频),浪费了多达 53.3% 的能耗
- 基于强化学习/历史学习的方案(如 zTT、GearDVFS):
- 决策周期长(需 100~200ms 数据收集),在新应用启动或资源变动时需要长达 480~700 秒的重新训练,无法应对毫秒级的瞬态突变
- 静态查表方案(如 Quickstep):
- 无法适应后台多任务运行引起的动态内存与计算资源变化
- 默认系统 DVFS 滞后:
(2) TurboInfer System Architecture
TurboInfer 的核心思路是: 在 GPU Stall 时以毫秒级精度瞬间降频省电,在计算 Kernel 启动的瞬间立即恢复高频
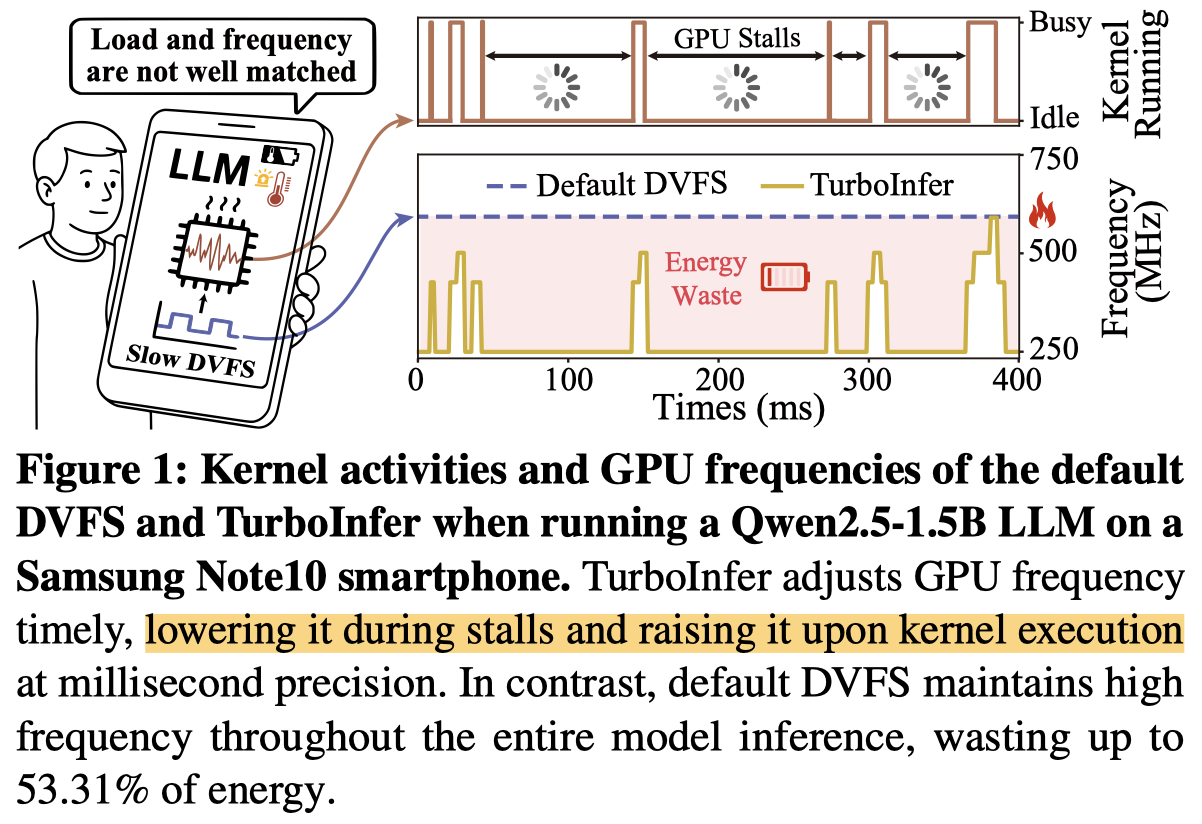
为了实现该目标,系统设计了两个核心组件:
[1] Real-time Workload Perception:
- 绕过离线 Profiler:
- 现有的 Systrace、Ftrace 或 AGI 工具都是事后离线分析,无法用于实时决策
- 直接读取硬件 PMU 寄存器:
- 通过内核接口直接采集 GPU 性能监视单元(PMU)的实时硬件计数器(如
SP_ALU_INSTRUCTIONS等与计算负载强相关的寄存器) - 这些寄存器每隔几微秒更新一次,开销极低(每次读取仅约 5µs)
- 通过内核接口直接采集 GPU 性能监视单元(PMU)的实时硬件计数器(如
[2] Responsive Frequency Scheduler:
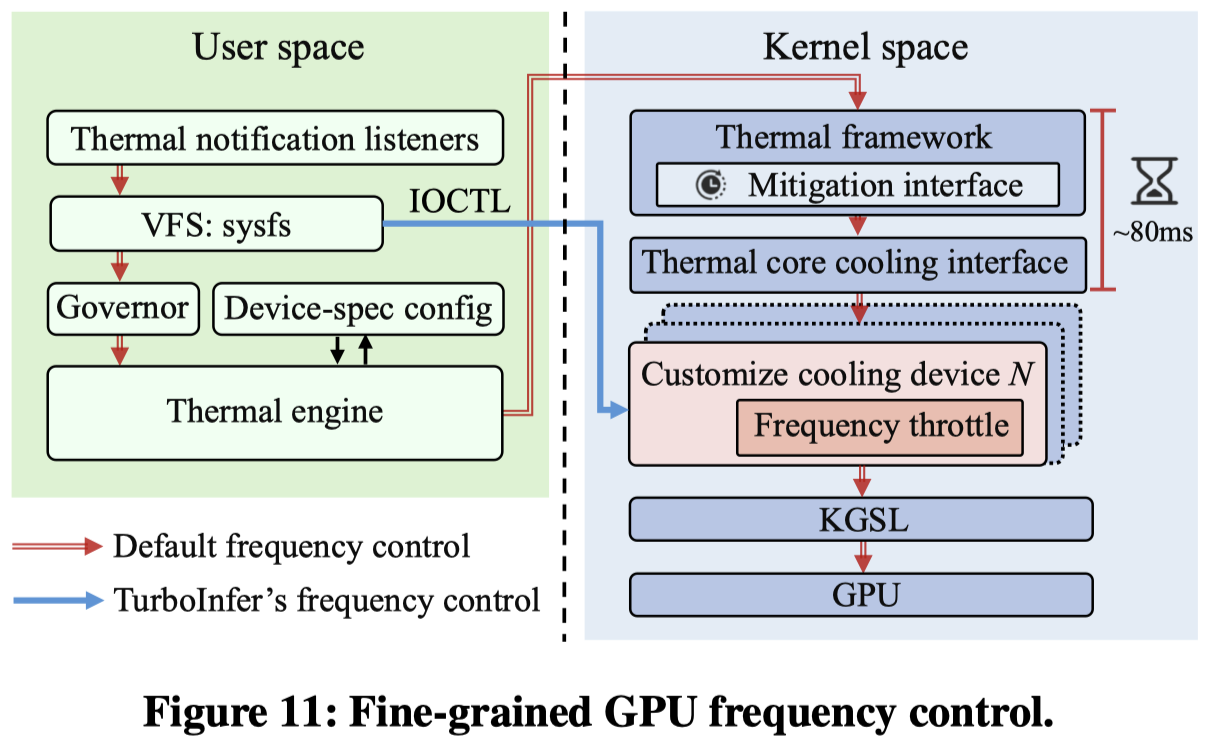
-
打通内核毫秒级调频通道:
- 常规 Android 系统中,用户空间发出的调频指令会被内核散热框架(Thermal Framework / Mitigation Interface)聚合缓冲(通常每 80ms 处理一次),导致毫秒级调频失效
- TurboInfer 通过注册自定义 Cooling Device,并利用 KGSL(内核图形支持层)的 IOCTL 直接对接底层硬件,实现了亚毫秒级(调频开销 < 2.5µs)的即时硬件频率调节
-
基于管道模型预测控制(Tube-based MPC, TMPC)的动态调频:
- 定义 频率敏感度(Frequency Sensitivity) \(S_t = I_t / F_t\)(指令数/频率),旨在让系统稳定运行在能效最优的 “Sweet Spot”
- 将前台 LLM 作为主控目标,将后台动态应用(如短视频、导航等)的资源争用建模为外部干扰项 \(w_t\)
- 通过离线求解离散代数黎卡提方程(DARE)计算状态反馈控制器参数 \(K\),确保系统在动态干扰下的快速收敛与鲁棒性
- 引入“管道(Tube)”约束:限制目标状态的突变范围,防止因后台应用突发负载导致频率频繁剧烈震荡而拖慢前台 Kernel 执行
-
求解器降维极速加速(Expedite the Solver):
- 标准二次规划(QP)求解耗时约 1.3ms,对于运行时间低于 1ms 的短 Kernel 依然过慢
- 关键物理洞察:手机 SoC 采用无风扇垂直层叠设计,芯片温度的一阶导数峰值 \(\vert{}\frac{dT}{dt}\vert{}_{peak}\) 与瞬时功耗和频率呈现严格的线性相关性
- 基于该规律,TurboInfer 将优化状态从三维向量 \([f_t, s_t, T_t]^T\) 降维至仅包含敏感度 \(s_t\) 的一维优化问题,将 QP 求解延迟从 1.2ms 骤降至 0.14ms
(3) Evaluation
-
原型实现:
- 基于 MLC-LLM(v0.19.0)实现,包含约 4200 行 C++ 代码,作为独立插件运行
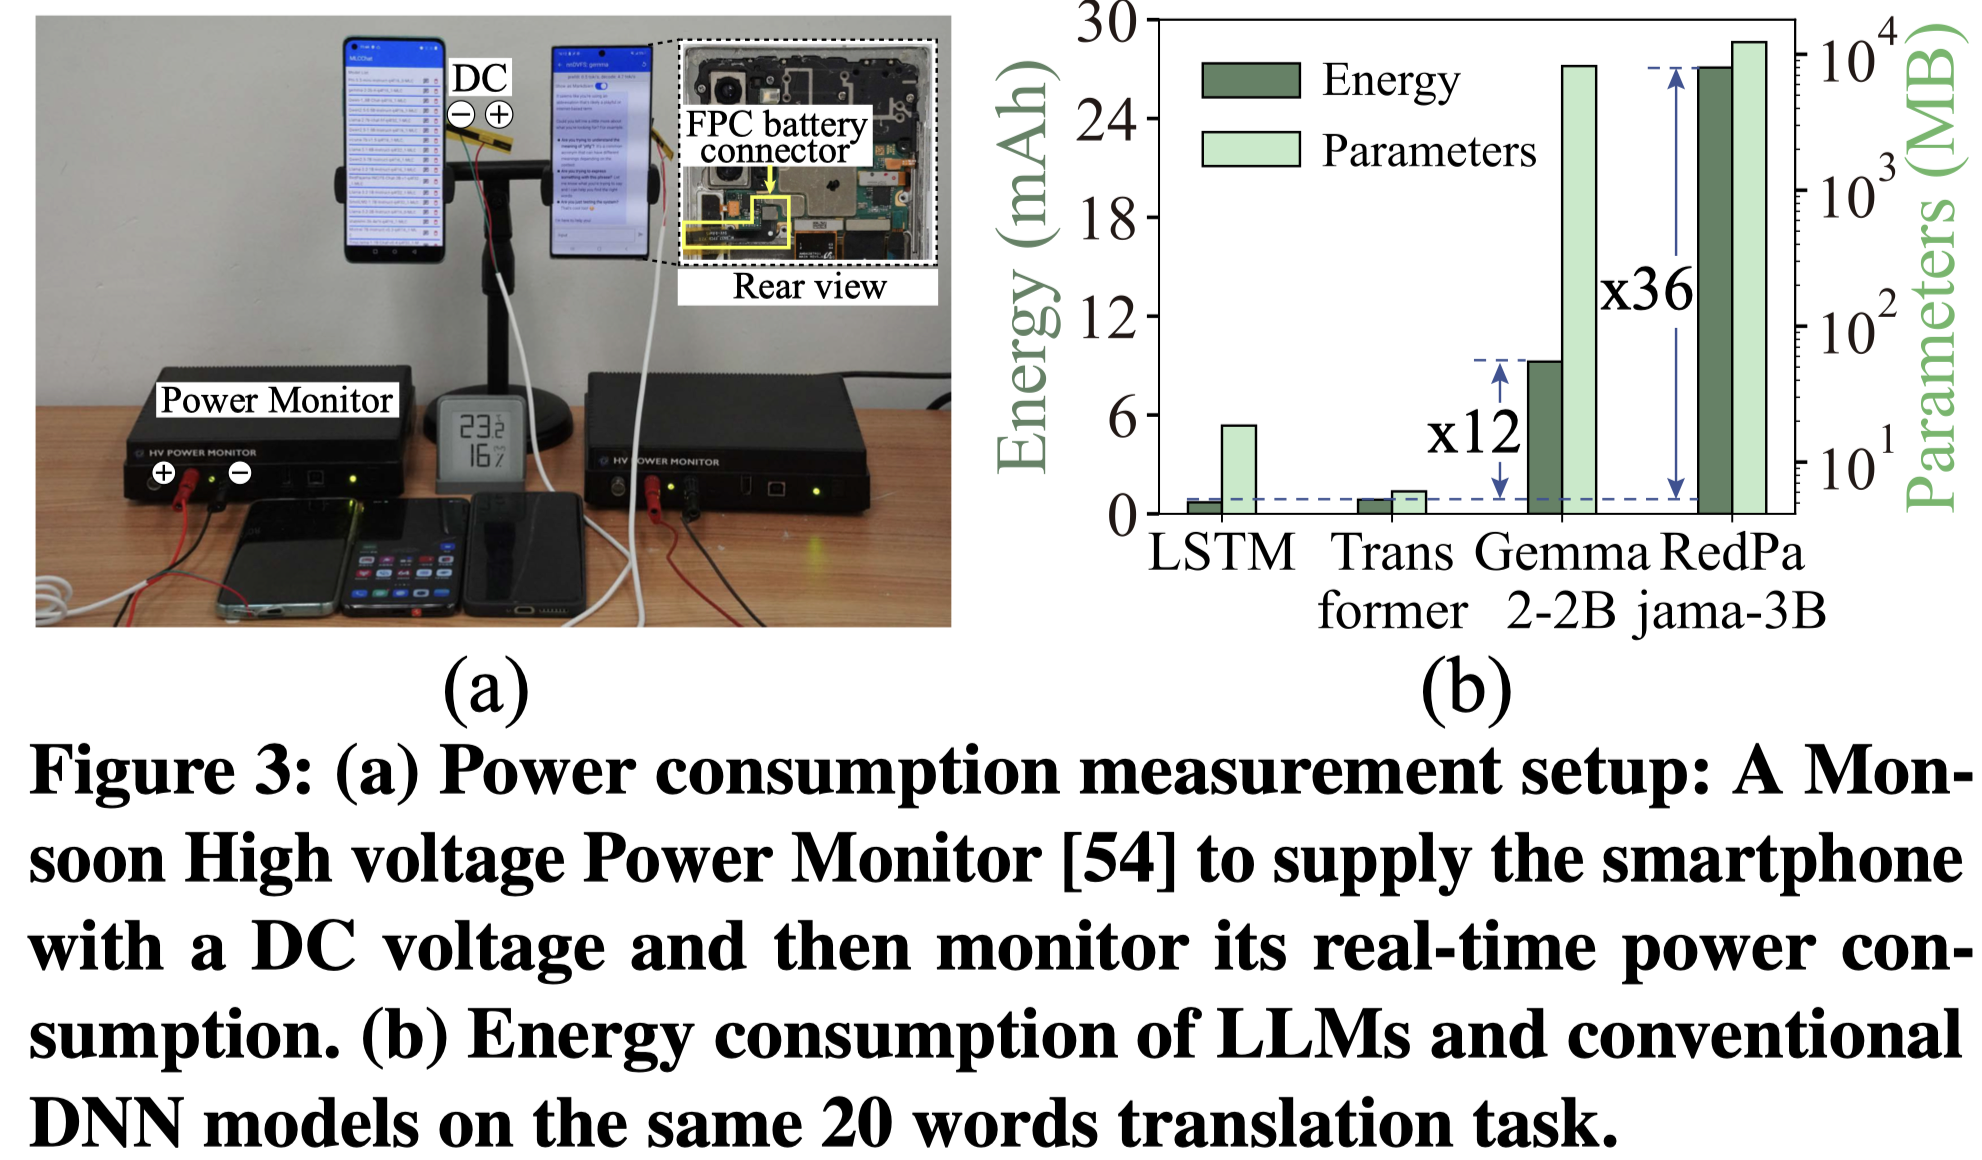
-
硬件与模型平台:
- 测试设备:一加 8(OnePlus 8)、三星 Galaxy Note 10
- 评测模型:Qwen2.5-1.5B、Gemma2-2B、RedPajama-3B(避开了需要频繁产生 Swap 的 7B 超大模型,以保证评测公平性)
- 对比基线:Android 原厂默认调频器(msm-adreno-tz)与移动端 SOTA 方案 zTT