Harvesting Spare CPU Resources in Container Systems¶
好文章! 非常值得学习. 跟笔者研究领域不直接相关,因此用AI辅助简单读了一遍. 梳理了一下核心机制, 还没太细看
1. 问题到底是什么¶
1.1 为什么延迟敏感容器要超配¶
延迟敏感服务(Memcached、MySQL、搜索引擎 Xapian)的 SLO 通常卡在 P99 尾延迟上,也就是 100 个请求里最慢的那一个也不能超过某个值。尾延迟对"排队"极其敏感。一个请求到达后,处理它的线程被唤醒,如果此刻所有核都在忙,这个线程只能进入某个核的运行队列(runqueue)等待。
在 µs 级 SLO 下,哪怕等上一个调度片(毫秒级),这个请求也会直接变成尾部。
因此运维人员按峰值来配核。例如 MySQL 的峰值需要 8 核,就给它 8 核,保证"突发时所有就绪线程都能立刻找到空核"。
1.2 空闲核从哪来¶
请求到达本身就是突发的,所以 CPU 使用也是突发的。Fig. 1 是 MySQL 在 5 ms 内的核使用情况:平均约 4 核,有些时刻 8 核全满,有些时刻只用 1~2 核。
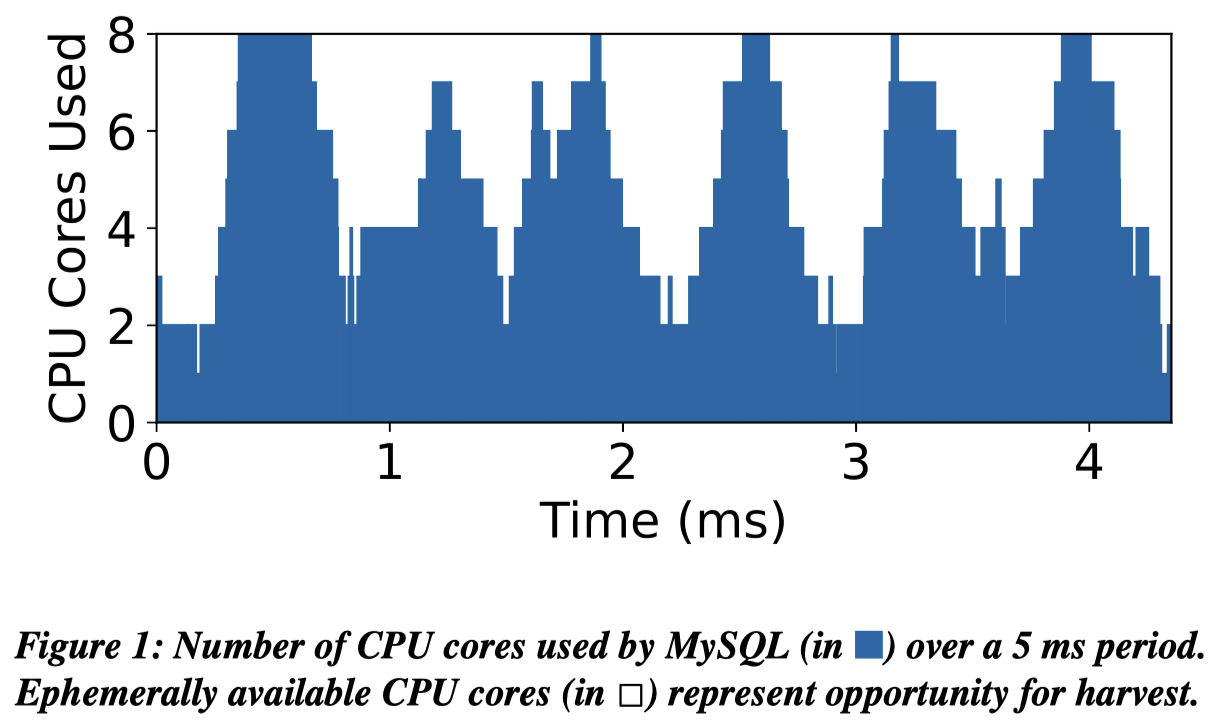
也就是说,平均来看有一半的核在空转,但这些空闲是"瞬时"的,每段空闲可能只持续几十到几百微秒。论文把这些核称为 ephemerally available cores(瞬时可用核)。
1.3 收割的两个核心难点¶
难点一:必须足够快。 空闲窗口只有微秒量级。如果"发现某核空闲 → 把吞吐型任务迁过去"这个过程要花毫秒,等迁过去时窗口早就结束了,甚至可能正好撞上 Primary 的下一次突发。所以核的重新分配必须在微秒级完成。
难点二:不能全借出去。 假设当前 8 核中有 5 核空闲,全部借给吞吐型任务。下一瞬间 Primary 来了一波请求,唤醒 3 个线程,这 3 个线程会发现没有空核,只能和吞吐型任务抢同一个核。这正是尾延迟暴涨的根源。所以必须留一部分空闲核不借(后文的 Buffer),只借剩下的部分。留多少、留哪几个核,是整篇论文的主要设计内容。
2. 现有机制为什么不行¶
2.1 cgroups:按"时间"分,而不是按"核"分¶
Linux 容器的 CPU 限制来自 cgroups 的 cpu 子系统,主要有两个参数。
shares(权重):
- 含义:发生竞争时,各容器按权重比例分配 CPU 时间。
- 它是 work-conserving 的:没有竞争时,任何容器都可以用满空闲 CPU。
- 问题(补充):
- shares 只决定"长期来看谁多用一点时间",不决定"此刻谁先上核"
- Primary 的线程被唤醒时,如果它要去的核上正在跑吞吐型任务,Linux CFS 调度器不一定立刻抢占
- 是否抢占取决于双方的 vruntime 差和唤醒抢占粒度,吞吐型任务通常还能继续跑一小段
- 对 µs 级 SLO 来说,这一小段就足以造成违约
- 更根本的问题是:
- shares 不限制吞吐型任务能跑在哪些核上
- 它可以出现在全部 8 个核上,Primary 的任何一次唤醒都可能撞上它
quota(配额):
- 含义:在每个周期(默认 100 ms)内,容器最多只能运行 quota 这么多 CPU 时间,用完就被 throttle(冻结)到下一周期
- 问题:
- 它限制的是"总共跑多久",同样不限制"在哪个核跑、什么时候跑"
- 在配额用完之前,吞吐型任务依旧可以占着 Primary 马上要用的核
- 而配额一旦设得严,吞吐型任务能拿到的 CPU 就很少,收割量也就少了
Fig. 2 的实验把这个矛盾量化了。MySQL 在 5k RPS 下与一个会占满 CPU 的吞吐型容器共存:
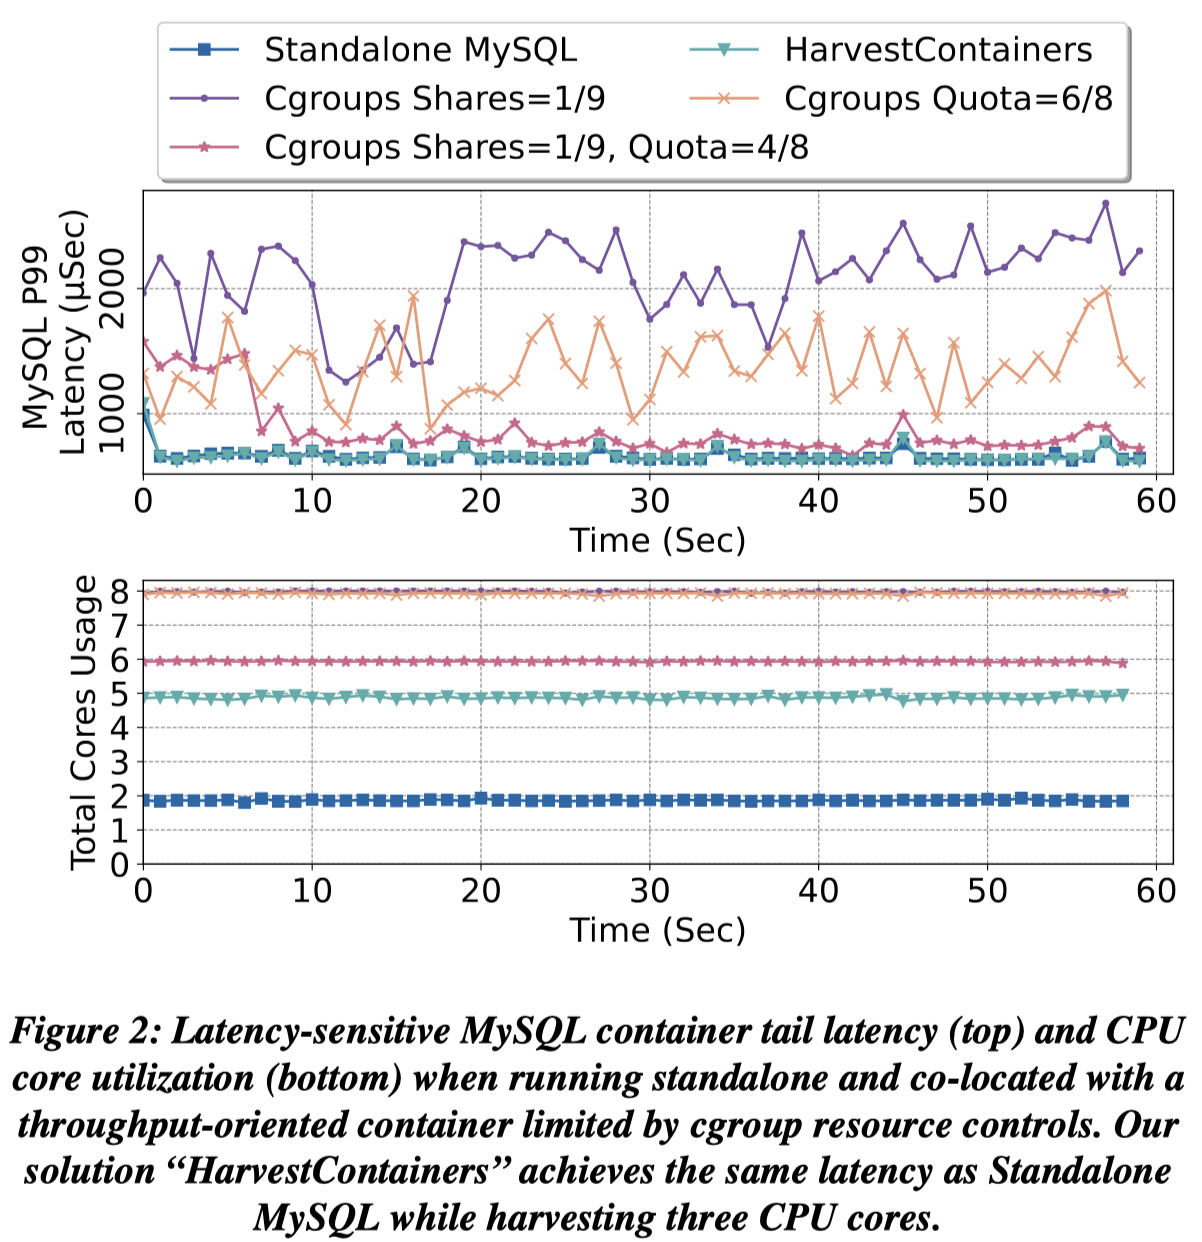
| cgroups 设置 | MySQL P99 相对独立运行 |
|---|---|
| shares = 1/9(吞吐型)对 8/9(MySQL) | +250% |
| quota = 6/8 核 | +225% |
| shares 1/9 + quota 4/8 | +19% |
限制越严,延迟越好,但收割量也越少,而且即使限制到这种程度,延迟仍然超出 19%。
作者的结论是:不存在一组 shares/quota 能同时做到"利用率高"和"尾延迟稳",因为这两个参数都工作在"时间维度、毫秒级",而问题出在"核维度、微秒级"。
执行速度也不够:cgroups 的约束通过周期性记账来执行,粒度是毫秒级,本身就跟不上微秒级的空闲窗口。
2.2 实时调度类 (RT)¶
Linux 还提供了实时调度类,作者逐一说明了它们为什么不能用:
- SCHED_FIFO:
- 高优先级线程一旦上核,就一直运行到自己阻塞或让出,没有时间片。
- 如果把 Primary 设成 FIFO,它确实总能抢占吞吐型任务。但如果应用写得不好,比如有自旋或长计算,它会把核一直霸占下去。
- 云平台上跑的是任意第三方容器,不可能要求它们都"懂实时",强行这么用会让平台不稳定。
- SCHED_RR:
- 在同优先级之间轮转,问题与 FIFO 相同,因为轮转只发生在同优先级内。
- SCHED_DEADLINE:
- 给任务一个 (runtime, deadline, period) 预算,能保证时延。
- 但为了维持准入控制,内核禁止这类任务 fork,而几乎所有应用都依赖 fork/exec,所以容器用不了。
2.3 Kubernetes¶
Kubernetes 的 CPU requests 和 limits 最终分别映射为 cgroups 的 shares 和 quota,因此继承了上面的全部问题。
Kubernetes 的 QoS 类里,Guaranteed 类(补充:配合 static CPU Manager 策略、请求整数核时)可以给容器分配独占核,这能保护延迟。但独占意味着这些核即使空闲,也不会借给任何人。
于是 Kubernetes 只提供两个极端:要么独占并浪费,要么共享并冒险。
2.4 中断:一个被前人忽视的干扰源¶
先说中断是怎么干扰的(补充)。 网卡收到包后触发硬中断,内核随后在某个核上执行软中断(NET_RX softirq)来完成协议栈处理。中断处理不是一个"线程",而是直接借用当前核运行:
- 如果这个核上正在跑 Primary 的线程,线程会被打断,打断多久,延迟就多久。
- 如果这个核恰好是 Primary 马上要用的空核,线程被唤醒时就会发现核正在忙中断,只能等待。
容器为什么中断更多。
容器通常使用 veth 对(容器内一端、宿主机一端)加上网桥。一个包从物理网卡进来,要经过网桥,再穿过 veth 进入容器,每经过一个虚拟接口都会触发一次软中断。
所以同样的流量,容器环境的中断次数可达物理机的 3 倍。
现有中断引导工具为什么不够:
- RSS(网卡硬件按流哈希分队列)、RPS(软件层面把包分到多个核)、irqbalance(用户态程序把中断均匀撒到各核):
- 目标都是提高吞吐、分摊负载,完全不知道"哪些核属于延迟敏感容器、应该回避"。
- RFS 和 Intel FlowDirector:
- 会把一条流的中断引到消费这条流的应用所在核上,对物理机上的进程很有效。
- 但在容器里,流要穿过 veth 和网桥,这些工具无法把宿主机上看到的流对应到容器内的应用。按论文的说法,它们"无法跨虚拟以太网接口追踪流"。
另一个关键点:中断对调度器不可见。
调度器判断"核是否空闲"时看的是运行队列上有没有任务。一个正在处理软中断的核,在调度器看来可能仍是空闲的。所以只靠调度器信息来找空核,会误把"忙于中断的核"当成可用的 Buffer。
2.5 学术界已有方案¶
| 方案 | 做法 | 在容器场景下的问题 |
|---|---|---|
| Caladan、Shenango | 自定义用户态线程库,配合一个专用核高速调度 | 应用必须改写、链接这个线程库,只适合高并发且愿意改代码的应用 |
| SmartHarvest | 在 VM 里收割,用 ML 预测需求 | 快速路径需要修改 Hyper-V;常规路径的核重分配约 10 ms;预测器倾向于高估需求 |
| PerfIso | 在 Windows 用户态通过系统调用监控和分配核 | 系统调用开销使它只能做到毫秒级;Buffer 大小固定,按峰值通过离线 profiling 确定 |
作者给自己的定位是:不改应用、不改 OS 源码、不做离线 profiling,还要把中断考虑进去。
3. 核心思想:模仿"独立运行"¶
这是全文最重要的一个想法,值得仔细理解。
Primary 独立运行时是什么状态?8 个核全归它!
当线程被唤醒,调度器会找一个空闲的核放上去(补充:Linux 的唤醒路径会优先选择 cache 亲和的空闲核),所以线程几乎不用排队,而且常常落在刚用过、cache 还热的核上。这正是它能达到低尾延迟的原因。
收割之后如何保持这一点? 只要保证"Primary 线程被唤醒的那一刻,总有空闲核可以直接用",Primary 就感觉不到自己在和别人共享
所以作者的做法是:
- 在 Primary 的空闲核里始终保留若干个真正空着的核,称为 Buffer 核
- 其余空闲核借给吞吐型容器,称为 Harvest 核
用集合关系表示:
| Text Only | |
|---|---|
1 2 3 4 5 | |
一个具体例子(补充,用于理解机制)。 假设 Primary 配 8 核,此刻 2 核忙,Buffer 目标为 3:
- 空闲核有 6 个,其中 3 个作为 Buffer,另外 3 个借给 Secondary
- 突然到来一波请求,唤醒 3 个线程。调度器把它们放到 3 个空闲的 Buffer 核上,无需排队
- 此时 Buffer 被用光了(盈余变成了亏空)
- Monitor 在约 60 ns 内发现,Actuate 立即把 Secondary 从 3 个 Harvest 核中的若干个上赶走
- 这些核变回 Primary 的空闲核
- Buffer 恢复为 3
- 如果这一波唤醒了 4 个线程(超过 Buffer),第 4 个线程会落到一个正在运行 Secondary 的核上,与之竞争并产生排队延迟,直到回收完成
由此可以看出 Buffer 大小的含义:在回收动作完成之前的那一小段时间里,Primary 能够无损吸收多少个同时唤醒的线程。
- 回收越快,需要的 Buffer 越小,可收割的核就越多。这就是作者如此强调"微秒级 Actuate"的原因
- 反过来,SmartHarvest 回收需要约 10 ms,就只能留很大的 Buffer,几乎收割不到核(论文后面的对比实验正是在说明这一点)
另一个关键原则:只改 Secondary,永远不动 Primary。
论文明确说 Actuate 从不修改 Primary 的核分配。Primary 的亲和性始终是全部 8 个核,所以从 Primary 的视角看,它一直"拥有"8 个核,调度器会像独立运行时一样为它选核。
被借出去的核只是"上面临时多了一个 Secondary 线程"。系统能调节的只有 Secondary 被允许跑在哪些核上,通过扩缩 Secondary 的核集合来实现借出和收回。
4. 四个操作逐一展开(§3.1–§3.6)¶
先区分两个概念:
- surplus(盈余):当前空闲核数 > Buffer 目标,多出来的部分可以借出。
- deficit(亏空):当前空闲核数 < Buffer 目标,需要从 Secondary 那里收回核。
4.1 Monitor:实时掌握每个核的状态¶
记录什么:
- Primary 每个核此刻是 Active 还是 Idle。
- 累积统计:每个核被 Primary 和 Secondary 使用的频率;Primary 在一段时间内处于盈余或亏空状态的时长(用于计算后文的 ACBF)。
- 每个核处理中断的时间。这是调度器看不到的,需要单独采集。
为什么必须快:
- 空闲窗口很短,发现晚了就收割不到。
- Buffer 被用掉后,要立刻补足,否则下一波突发就没有保护。
- 中断活动要尽早识别,才能在它干扰 Primary 之前做出反应。
为什么可以在内核里做:
所有容器共享同一个内核,所以在内核模块里就能看到全部容器的全部核状态,不需要像 Caladan 那样改应用,也不需要像 SmartHarvest 那样改 hypervisor
4.2 Balance(一):Buffer 应该多大 —— ACBF 启发式¶
第一步:用什么量刻画"需要多大的 Buffer"?
需要多大 Buffer,取决于 Primary 的突发性:短时间内同时有多少线程被唤醒、同时需要空核。作者没有直接去测"同时唤醒的线程数"(那样要侵入应用),而是用一个间接指标:
ACBF(All-Cores Busy Fraction):在一个采样周期内(默认 1 秒),Primary 的全部配额核(如 8 个)同时处于忙碌状态的时间占比。
为什么选"全部核都忙"这个事件? 因为这正是尾延迟产生的时刻。独立运行时,8 核全忙意味着此刻再有线程被唤醒就只能排队。
ACBF 衡量的就是 Primary"多频繁地真正需要全部核":
- ACBF 越高,说明突发越强、越频繁,需要留的 Buffer 越多。
- ACBF 越低,说明很少出现全核同忙,Buffer 可以缩小。
ACBF 与负载的关系(Fig. 3):它随 RPS 单调上升。例如 Xapian 在 4k RPS 时 ACBF 为 0.13(1 秒内约 13% 的时间 8 核全忙),在 2k RPS 时为 0.01。数值普遍很小,这恰恰说明这些服务的突发是"短暂但不可预测"的:大部分时间用不满,但偶尔会瞬间全满。
- ACBF 上升称为 waxing(盈,负载在变重)。
- ACBF 下降称为 waning(亏,负载在变轻)。
第二步:Observation Phase——先建立"正常范围"。
- 每个 Primary 刚部署时,都先进入观察期,持续 60 秒。
- 观察期内完全不收割,Primary 相当于独立运行,这样测到的 ACBF 不受 Secondary 干扰,代表它在当前负载下的真实突发特征。
- 每秒计算一个 ACBF,60 秒得到 60 个点,构成 ACBF 曲线。
- 取这条曲线的最大值 ACBF_High 和最小值 ACBF_Low,形成一个窗口,称为 CHW(Current Harvest Window,当前收割窗口)。
CHW 的含义是:"在当前这个负载水平下,ACBF 正常情况下会在这个范围内波动。" 之后就拿它当基准,判断负载是否发生了变化。
第三步:Harvest Phase——对照窗口调整 Buffer。
进入收割期时,Buffer 先设为最大值(最保守,几乎不借出),然后逐步调整。
每个采样周期算出当前的 ACBF_Current,与窗口比较:
| 情况 | 解读 | 动作 | 设计理由 |
|---|---|---|---|
| ACBF_Current > ACBF_High | 全核同忙比平时更频繁,负载在变重 | 立即 Buffer +1 | 保护延迟优先。作者认为每次只加 1 就够了,因为系统反应足够快,下一个周期还会再检查,不需要一次加很多 |
| 落在 CHW 内 | 负载与观察期时一致 | 不急于行动,再积累约 10 秒样本,确认负载稳定后再逐步缩小 Buffer | 缩 Buffer 是有风险的方向,所以要求更多证据 |
| ACBF_Current < ACBF_Low | 比平时还闲,负载在变轻 | 立即缩小 Buffer | 信号很明确,缩小的把握度高 |
这里体现了一种不对称的谨慎:变大很积极,变小要看情况。明确变闲时才立刻缩小,状态模糊时要多观察一会儿
Tip
有点像 TCP 的 AIMD (Additive Increase, Multiplicative Decrease) "反过来"
第四步:什么时候重新观察?
如果 ACBF 一直高于窗口,Buffer 会一路 +1 加到最大。加到最大后 ACBF 仍然高于窗口,说明负载已经进入一个新的、更高的水平,旧窗口作废。这时系统会:
- 停止收割,Buffer 等于全部空闲核;
- 重新进入 60 秒观察期,建立新的 CHW;
- 然后回到收割期。
注意,只有 waxing 会触发重新观察。waning 时直接缩小 Buffer 就行,因为变闲时继续沿用偏保守的旧窗口不会伤害延迟。作者预期系统大部分时间处在收割期,只是偶尔回到观察期。
Fig. 4 的完整过程:
- ①:Primary 在 1k RPS 下观察 60 秒,得到窗口(蓝线)。
- ②:进入收割期。负载升到 1.5k RPS,ACBF 冲出窗口上沿(红线),Buffer 逐个 +1,一直加到最大,ACBF 仍然高于窗口。
- ③:触发新一轮观察,建立与 1.5k RPS 匹配的新窗口。
- ④:回到收割期(绿线),ACBF 处在窗口内或窗口下方,于是可以安全地缩小 Buffer,重新开始收割。
第五步:两个时间尺度,别混淆。
| 调整对象 | 时间尺度 | 原因 |
|---|---|---|
| Buffer 的目标大小 | 秒级 | 由 ACBF 驱动,ACBF 每秒才算一次;一种负载下的理想 Buffer 不会频繁变化 |
| Harvest 核的借出和收回 | 微秒级 | 为了维持 Buffer:Primary 一用掉 Buffer 核,就立刻从 Secondary 收回一个核补上;Primary 一释放核,多出来的立刻借出去 |
可以这样理解:ACBF 负责决定"水位线"放在哪里(慢变量),Monitor 加 Actuate 负责实时把水位维持在这条线上(快变量)。 真正在毫秒以内扛住突发的,是"Buffer 始终有空核"这个状态本身,而不是 ACBF。
4.3 Balance(二):让哪几个核当 Buffer¶
确定了 Buffer 要几个核之后,还要决定具体选哪几个核:
- ==Primary 最近用过的核优先做 Buffer。 ==
- 这些核的 L1/L2 cache 里还留着 Primary 的数据和指令。线程被唤醒后落在这些核上,cache 是热的,执行更快
- 在 µs 级延迟下,一次 cache 冷启动的开销就很可观
- 中断重的核优先做 Harvest。
- 这些核经常被中断打断,给 Primary 用会伤延迟,给不在乎延迟的 Secondary 用正合适
- 在剩下的核里,中断越少的越优先做 Buffer
- 实现部分的原文:先看最近是否被 Primary 使用,再看中断最少
4.4 Actuate:执行借出和收回(§3.4)¶
- 出现亏空(Buffer 不够):立即把 Secondary 的线程从某些 Harvest 核上赶走,这些核重新变成 Primary 独享的空闲核,Buffer 得到补足。
- 延迟越大,Primary 在下一波突发中裸奔的时间越长。
- 出现盈余(空闲核多于 Buffer):立即把 Secondary 的线程迁到新的 Harvest 核上。
- 延迟越大,这个瞬时窗口就越可能被浪费掉。
作者把这两个动作称为收缩(shrink)和扩张(grow) Secondary 的核集合,二者在容器整个生命周期内持续进行。Actuate 的难点在于如何让扩张真正做到立即生效,见第 6 节的 Two-Phase Affinity。
4.5 中断管理(§3.5)的三项措施¶
- 把中断绑定到一组非 Primary 核上。 系统预先划定一组核专门处理中断(例如 Secondary 自己的独占核),这组核与 Primary 的配额核不重叠。
- 绑核本身不是新技术,作者强调的区别在于两点:
- 一是保证中断永远有核可用,不会因为收割而无处可去;
- 二是保证这些核与 Primary 不重叠,而 irqbalance 这类工具做不到这一点。
- 作者还提到,在他们的经验里,这样做不会影响容器内应用的正常运行。
- 中断亲和性随 Harvest 核动态扩缩。
- Harvest 核本来就是借给 Secondary 用的,Secondary 的网络中断也可以跟着用这些核
- 核被收回时,中断也随之撤出。机制与 Secondary 线程的扩缩完全相同
- 中断重的核优先作为 Harvest 核,即 4.3 节的规则 2
共用网卡的情况: 如果 Secondary 有自己的网卡,措施 1 和 2 都能完整实施。如果 Primary 与 Secondary 共用一块网卡,中断无法按容器区分,只能依靠措施 3,把中断重的核偏向 Secondary。
4.6 Listen:与编排器对接(§3.6)¶
每台服务器上运行一个 Listen agent,负责两件事:
- 向上汇报:本机还有多少可以独占的核能提供给新的 Primary,以及有没有足够的空闲资源供 Secondary 使用。
- 向下接收:编排器决定在本机部署容器后,通知 Listen 这是 Primary 还是 Secondary、需要多少核,以便 HarvestContainers 开始管理它。
5. 设计上的取舍与局限(§3.7)¶
作者把自己定位为"黑盒但足够快"的中间路线,并与三类方案做了比较:
| 方案类别 | 优点 | HarvestContainers 付出的代价 |
|---|---|---|
| 改应用(插桩、自定义线程库) | 能精确知道应用内部的负载动态 | 只能通过 ACBF 这种外部统计间接推断;负载剧变时要切回观察期,期间暂时收割不到核(作者认为这个成本可以在容器的整个生命周期内摊薄) |
| 改 OS(绕开调度器,自己放置线程) | 对线程放置有完全控制,还能顺带管理内存、cache 等资源 | 只能与现有调度器配合,接受它的行为;将来调度器改版需要跟着适配。不管理内存、cache,但可以与 Intel CAT 等机制叠加 |
| 纯系统调用(如 PerfIso) | 同样不改 OS 和应用 | 系统调用开销使它们只能做到毫秒级,收割量有限 |