FBLayout: Optimizing Memory Layout for Efficient LLM Finetuning on Mobile GPUs
主题: 在移动 GPU 上优化 LLM 微调的内存布局
(1) 研究背景与面临的挑战
- 背景:
- 基于 Transformer 的模型在各类任务中展现了强大的能力。为了提供个性化体验并保护用户隐私,直接在移动设备上对这些大模型进行微调(On-device fine-tuning)变得至关重要
- 移动端微调的三大挑战:
- 极高的内存消耗: 训练需要保存前向传播的中间激活值用于计算梯度,其内存足迹通常是推理的 7 到 10 倍,容易耗尽移动设备的内存
- 计算需求密集: 反向传播的计算量巨大,长时间的训练会导致移动设备"发热降频"
- 频繁的内存布局转换(最核心痛点):
- 微调过程中,注意力机制等操作需要频繁进行数据的 reshape 和 transpose
- 破坏了数据的局部性,给移动端本就受限的内存带宽带来了极大的压力
(2) 根本原因: 前向-反向布局冲突 (FB-Layout Conflict)
- 双向数据流差异:
- 与仅需一次性消费数据的 推理 不同,训练 阶段在反向传播时需要重用前向传递产生的 Tensor
- 然而,由于数学反向传播的特性,前向和反向通道对同一个张量的访问模式往往是冲突的
- 例如,矩阵乘法在两个通道中的归约维度不同
- 现有框架的妥协与缺陷:
- 重用布局策略(如 MNN 框架): 在反向通道中强行复用前向通道的最佳布局
- 这导致反向计算时出现跨度极大的非连续内存访问,造成严重的缓存未命中(Cache Thrashing)
- 显式转换策略(如 TFLite 框架):在算子之间插入显式的布局转换算子(如转置)
- 这虽然保证了单个算子的效率,但带来了巨大的额外计算开销和内存碎片
- 重用布局策略(如 MNN 框架): 在反向通道中强行复用前向通道的最佳布局
- 此外,移动 GPU 采用的是 2.5D 的 Texture Memory 架构:
- 该架构专门为 2D 空间局部性 进行了优化,传统的线性内存布局无法充分利用这一硬件特性
(3) FBLayout 的核心设计与方法
为了解决上述瓶颈,论文提出了 FBLayout (Forward-Backward unified Layout) 框架
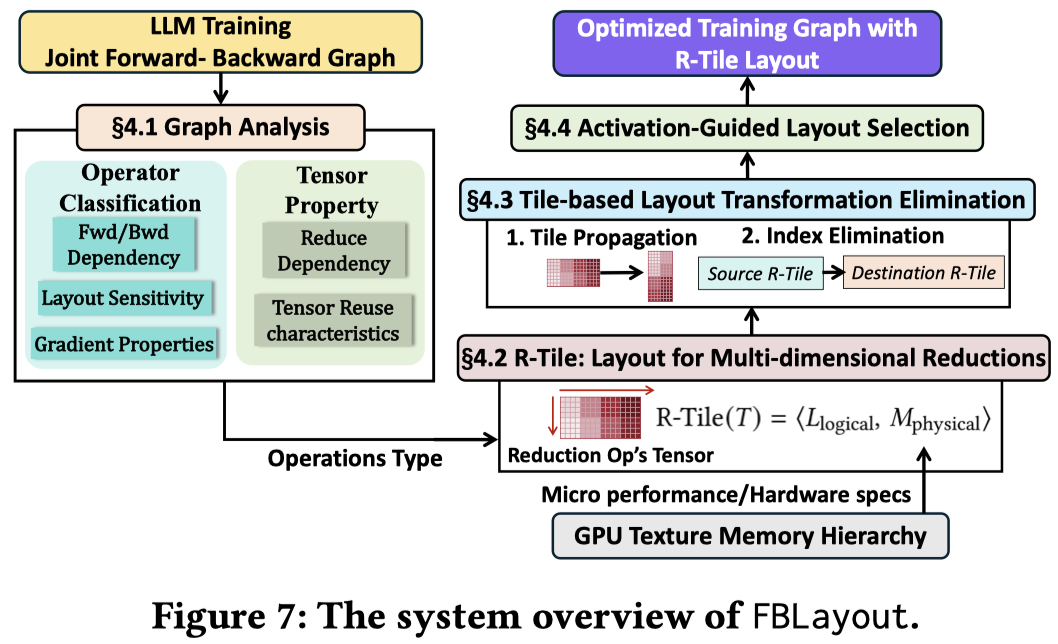
该框架将张量组织与移动 GPU 硬件特性进行了协同设计,主要包含以下四个核心模块:
-
算子分类:
- 根据 “是否依赖前向张量” 和 “访问模式是否一致” 两个维度,将模型中的算子划分为四类
- 这为后续系统地识别布局冲突和制定优化策略提供了理论基础
-
R-Tile: 统一的多维归约布局
- 针对存在归约维度冲突的关键算子(如矩阵乘法),FBLayout 提出了 R-Tile
- 它的核心洞察是“Tile 不变性”:无论沿着哪个维度进行归约,Tile(数据块)内部的元素都会作为一个原子单位被加载
- R-Tile 将数据精巧地映射到 2.5D 纹理内存中(包含 Tile 间排布和 Tile 内排布),使得前向和反向传递都能实现高效的连续访问,无需切换布局
-
基于 Tile 的索引转换消除
- 对于重塑(Reshape)和转置(Transpose)等会带来大量开销的显式转换算子,FBLayout 会验证它们是否破坏了数据的 Tile 结构
- 如果结构保持完整,FBLayout 就会将物理上的数据,搬运替换为轻量级的 Tile 坐标映射,从而彻底消除这些昂贵的转换操作
-
Activation-Guided 全局布局选择
- 仅优化单个算子是不够的
- FBLayout 通过分析计算图中激活值的重用模式,将高效的布局决策在全局范围内进行传播和精炼,确保整个计算图的转换成本最小化
(4) 实验评估与结果
- 测试环境:
- 在搭载 ARM Mali 和 Qualcomm Adreno 芯片的多种主流智能手机上,对 7 种代表性的 Transformer 模型(包括 LLaMA, Qwen, Gemma, BERT, ViT, Whisper, Stable Diffusion)进行了评估
- 显著的性能提升:
- 相比于现有的移动端框架(MNN, TFLite, TVM),FBLayout 实现了 2.2 倍到 5.7 倍的训练加速
- 大幅提高了硬件利用率,并将缓存未命中率降低了平均 4.2 倍,显著减少了全局内存访问的压力
- 降低了 3.5 到 6.3 倍的能耗,且其编译时间非常短,在实际移动端部署中具有极高的可用性
总结
提出了一种针对移动 GPU 架构量身定制的内存布局优化方案
通过 R-Tile 和全局索引优化,它完美化解了 Transformer 模型在微调时固有的“前向-反向布局冲突”,让在手机等移动设备上高效微调大型模型成为了现实