CascadeNet: Generating Network Traffic with High-Fidelity Temporal Patterns¶
TL; DR:
现有 ML 流量生成器能复现字段的统计分布,但复现不了流量随时间的变化(时间模式)。作者认为根因在数据表示,于是把每条流聚合成定长时间序列来学习,再用分层 GAN(CascadeGAN)按 "5 元组 → 时间序列 → 包字段" 由粗到细生成,最后把时间序列还原为逐包时间戳。
1. 问题:时间模式保真度差¶
时间模式指网络行为随时间的演化,用包速率、吞吐、包间隔(IAT)、流持续时间等指标衡量。它直接影响三类下游任务:突发(burst)分析、吞吐预测、基于 IAT/pps 特征的异常检测。
Fig. 2(CAIDA 包速率曲线)展示了现有方法的问题:
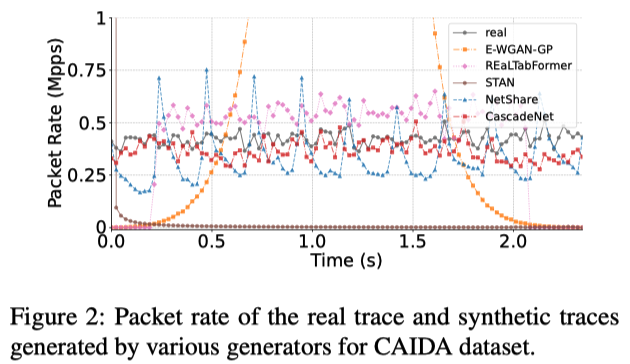
- E-WGAN-GP 和 STAN 的包速率完全失真。
- NetShare(SOTA)学出了真实数据中不存在的周期性模式。
2. 根因:数据表示方式¶
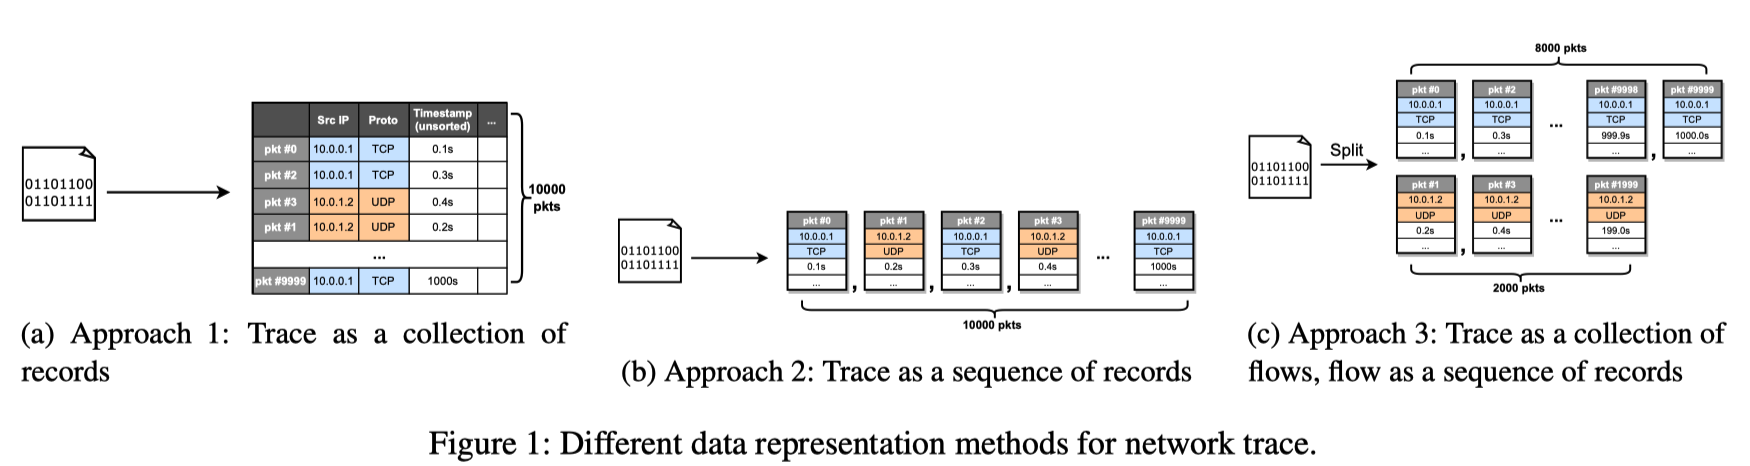
| 表示方式 | 代表 | 问题 |
|---|---|---|
| ① trace = 记录的无序集合 | E-WGAN-GP、PAC-GAN、PacketCGAN、CTGAN | 完全忽略记录之间的关系 |
| ② trace = 记录序列 | STAN、TimeGAN、TimeVAE、DoppelGANger | 序列过长,自回归模型难以捕捉长程依赖 |
| ③ trace = 流的集合,每条流是记录序列 | NetShare | 大象流仍有上万条记录,序列依旧太长 |
核心洞察:时间模式本来就是隐式的。它不体现在单条记录的时间戳里,而是体现在多条记录的聚合量上(pps、throughput;IAT 与 pps 近似成反比)。所以应该让模型直接学聚合后的时间序列。
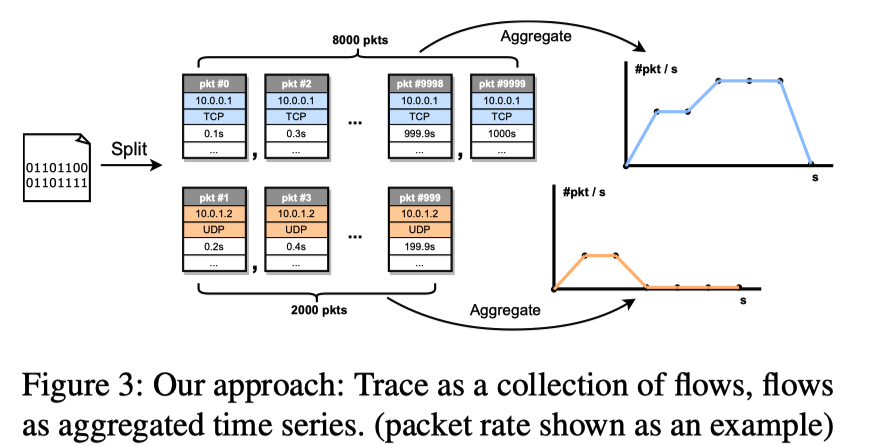
新表示:trace = 流的集合,每条流 = 定长聚合时间序列
如 Fig. 3 所示,好处有两点:
- 保真:序列长度由时间分辨率 T 决定,与流的包数无关,避开了长程依赖问题。
- 可扩展:序列变短,训练和生成的开销都下降。
3. 整体流程¶
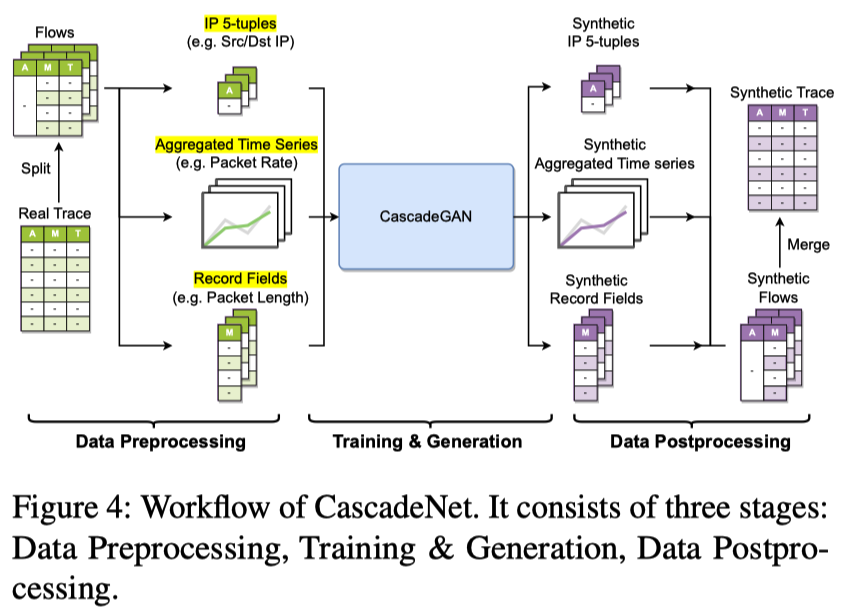
- 预处理:
- 按 5 元组切分成流
- IP 按 bit 编码(尽量避免记忆),端口和协议用 Word2Vec 编码
- 每条流聚合出包速率、吞吐等时间序列
- 其余字段中,类别型用 one-hot,数值型归一化到 [0, 1]
- 时间戳在这一步被丢弃,不直接学习
- 训练与生成:CascadeGAN 生成三类组件
- 后处理:解码后重组为 trace,并为每个包分配时间戳
4. CascadeGAN¶
形式化:流 Aᵢ(5 元组),时间序列 Sᵢ=(sᵢ,₁…sᵢ,T),记录字段 Mᵢ,ₜ,ₖ(第 i 条流、第 t 个时间步中的第 k 条记录)
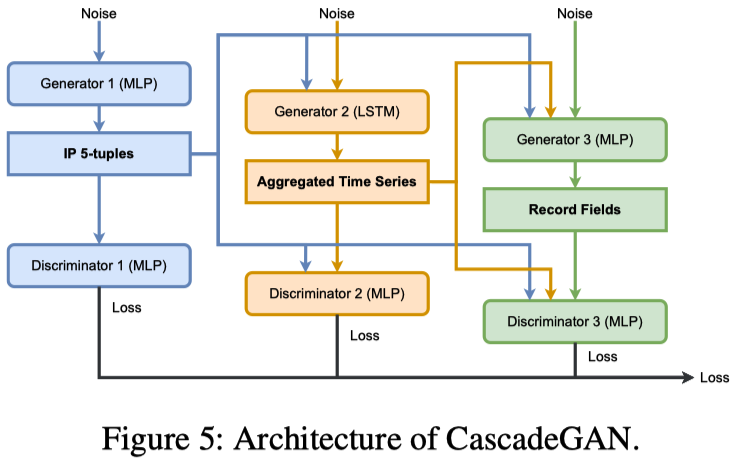
关键思路:直接学三者的联合分布很难,于是把它拆成条件分布链 P(A)·P(S|A)·P(M|A,S)
| 组件 | 生成公式 | 骨干网络 | 选择理由 |
|---|---|---|---|
| G1:5 元组 | Ã = G¹(z) | MLP | 数据是表格型 |
| G2:时间序列 | S̃ = G²(Ã, z) | LSTM | 序列建模能力强,附录 E 实验显示优于 MLP |
| G3:记录字段 | M̃ᵢ,ₜ,ₖ = G³(Ã, wnd(S̃,t), z) | MLP | 每个时间步的记录数不可控,用 LSTM 会重蹈 NetShare 的覆辙;MLP 符合"时间模式交给时间序列、步内关系简化"的原则 |
补充说明:
wnd(S̃,t)是以 t 为中心的滑窗,窗口大小为 11。它给 G3 提供足够的时间上下文,又不至于输入过多信息。- 三个判别器都用 MLP,损失采用 WGAN-GP(附录 C)。D2 以 (A,S) 为输入,D3 以 (A, wnd(S), M) 为输入。
训练:两阶段,解决"级联发散"问题
"级联发散"指上游生成器没训好时,会把失真的输入传给下游,把下游也带偏
- 预训练:三对 G/D 各自独立训练,G2 和 G3 的条件输入使用真实的 A 和 S
- 联合微调:用 L = αL₁ + βL₂ + L₃ 一起训练,α=β=1
- 另一个好处:
- GAN1 和 GAN2 以流为样本
- GAN3 以包为样本,而不同数据集的流/包比差异很大(0.001~0.54)
- 分阶段训练便于按数据集分别调整 epoch 数
5. 时间戳生成与优化¶
时间戳生成(§5.1)
| 方法 | 做法 | 特点 |
|---|---|---|
| EQ | 在每个时间步内均匀放置包 | 丢失步内的瞬时动态 |
| SP | 额外学习"子周期"(步内最早到最晚记录的间隔),在子周期内均匀放置 | 利用了"包在步内往往聚集"的观察 |
| ML(默认) | 把步内相对时间戳作为记录字段交给 G3 学,后处理时加上所在步的起始时间 | 保证与生成的时间序列严格一致,还可能恢复比 T 更细的模式 |
附录 F 显示 ML 方法在多数情况下最好
优化(§5.2)
- 零膨胀(Zero-inflation):时间序列中 0 很多(CAIDA 中 88%)。借鉴 Lambert 的 ZIP 模型,为每个时间步增加一个"是否有活动"的标志位,把"是否为 0"和"非零值的分布"分开建模。
- 条件输入:
- 少数大象流、大量老鼠流容易导致模式坍塌(mode collapse),而大象流又占了大部分包
- 作者没有用重采样(会改变分布),而是把流级特征作为条件输入:流持续时间、包数、最大/平均/标准差包速率、活跃步数、活跃步平均间隔等